
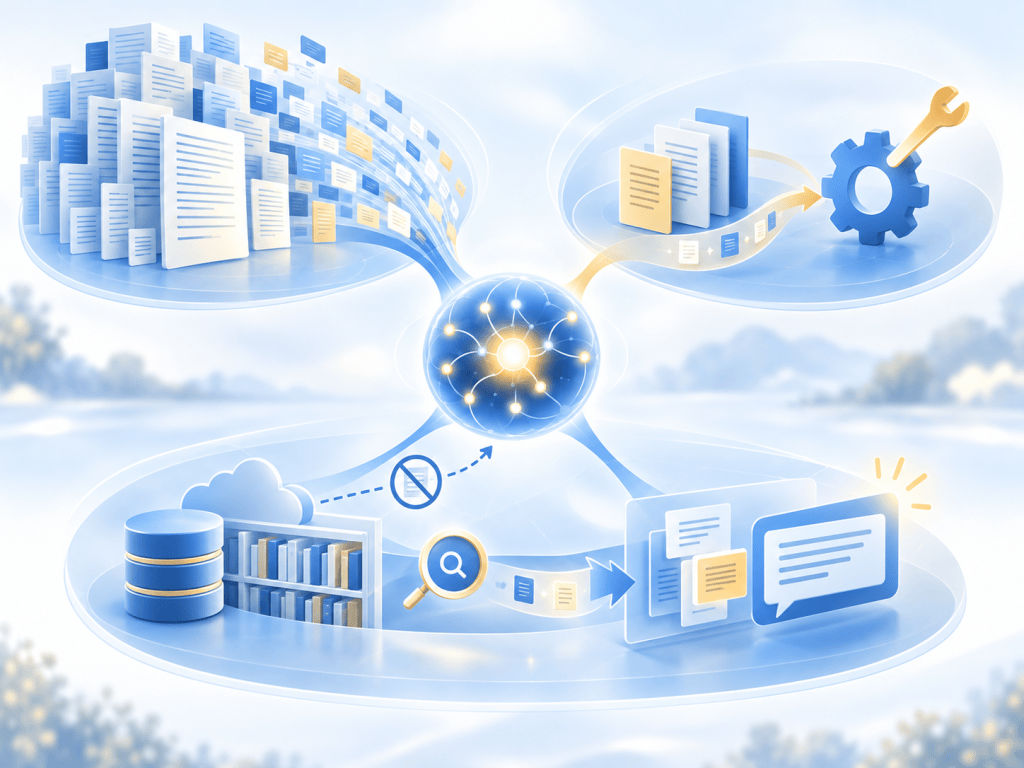
„Wenn ich einer KI mein Handbuch gebe – habe ich sie dann trainiert?“
Meistens: nein. Genau hier werden Training, Fine-Tuning und RAG oft in einen Topf geworfen.
Training
Training bezeichnet den Prozess, in dem ein Modell anhand vieler Daten so angepasst wird, dass seine internen Parameter für eine Aufgabe brauchbare Muster abbilden.
Beispiel: Ein Sprachmodell wird während des Trainings mit sehr großen Mengen Text konfrontiert und lernt statistische Zusammenhänge zwischen Tokens.
Trainingsdaten
Trainingsdaten sind die Daten, die im Trainingsprozess verwendet werden. Welche Daten ein konkretes Modell gesehen hat, wie sie ausgewählt wurden und unter welchen Bedingungen, ist eine Frage der jeweiligen Entwicklung und Dokumentation.
Beispiel: Für ein Bilderkennungsmodell können beschriftete Bilder Teil des Trainingsdatensatzes sein.
Inferenz
Inferenz ist die Nutzung des bereits trainierten Modells, um aus einer neuen Eingabe eine Ausgabe zu erzeugen. Dabei wird nicht automatisch das gesamte Modell neu trainiert.
Beispiel: Du stellst einem Sprachmodell heute eine Frage. Die Antworterzeugung ist Inferenz.
Fine-Tuning
Fine-Tuning bedeutet, ein bereits vortrainiertes Modell mit zusätzlichen Beispielen weiter anzupassen. Dabei werden Modellparameter verändert, damit das Modell bestimmte Aufgaben, Formate oder Verhaltensmuster besser trifft.
Beispiel: Ein Unternehmen kann ein Modell mit vielen guten Beispielen für ein gewünschtes Antwortformat weitertrainieren.
Fine-Tuning ist nicht einfach „eine Datei hochladen“. Es ist ein weiterer Trainingsschritt.
RAG – Retrieval-Augmented Generation
RAG kombiniert ein generatives Modell mit einem Such- oder Abrufschritt. Das System sucht passende Informationen in einer externen Quelle und gibt diese dem Modell für die aktuelle Antwort mit.
Beispiel: Ein Mitarbeiter fragt nach der aktuellen Reisekostenregel. Das System sucht im internen Handbuch nach relevanten Abschnitten und gibt diese an das Modell weiter, das daraus eine Antwort formuliert.
RAG ≠ Training.
Externe Wissensquelle
Eine externe Wissensquelle kann zum Beispiel eine Datenbank, ein Dokumentenspeicher, eine Website oder ein internes Handbuch sein. Das Modell muss diese Information nicht im Training gelernt haben, wenn das System sie zur Laufzeit abrufen kann.
Retrieval
Retrieval ist der Abrufschritt: Welche Dokumente oder Abschnitte werden für die aktuelle Frage gesucht und ausgewählt?
Beispiel: Bei der Frage „Wie lange ist die Kündigungsfrist?“ findet das System vielleicht drei Textstellen. Welche davon tatsächlich relevant ist, ist bereits ein wichtiger Teil der Qualität.
Warum RAG trotzdem falsch liegen kann
Der Zugriff auf eine Quelle ist noch keine Garantie für eine wahre Antwort. Fehler können an mehreren Stellen entstehen: Die falsche Quelle wird gefunden, eine relevante Stelle wird übersehen, die Quelle ist selbst veraltet, oder das Modell interpretiert den abgerufenen Text falsch.
Beispiel: Das System findet eine alte Version einer Richtlinie. Die Antwort kann sauber aus dieser Quelle formuliert sein – und trotzdem für heute falsch sein.
Was wird häufig verwechselt?
- RAG ≠ Training: RAG bringt externe Informationen in die aktuelle Antwort; Training verändert das Modell.
- Fine-Tuning ≠ aktuelle Wissensdatenbank: Fine-Tuning ist nicht automatisch die beste Methode für ständig wechselnde Fakten.
- Quelle verfügbar ≠ Quelle korrekt: Zugang sagt noch nichts über Aktualität oder Qualität.
- Retrieval ≠ richtige Schlussfolgerung: Ein gutes Suchergebnis muss noch korrekt verarbeitet werden.
Kurz gesagt
Fine-Tuning: Ein vorhandenes Modell wird gezielt weiter angepasst.
Inferenz: Das trainierte Modell wird benutzt.
RAG: Das System sucht externe Informationen und gibt sie für die aktuelle Antwort in den Kontext.
Retrieval: Der Such- und Auswahlvorgang nach relevanten Informationen.
Merksatz: Wenn jemand sagt „Die KI kennt unsere Daten“, frag nach: Wurde das Modell trainiert, fine-getunt – oder werden die Daten nur bei Bedarf abgerufen?
Vorher: Prompt, Kontext, Token und Memory
Weiter: Halluzination, Grounding und Provenance




Hinterlasse einen Kommentar